


Люди любят считать себя непредсказуемыми существами, в какой-то степени подчиняющимися свободной воле, которая каким-то образом возникает из физических процессов. Но вот вам любопытный факт, способный вызвать экзистенциальный кризис, основанный на лингвистике: большинство языков, похоже, подчиняется уравнению, известному как закон Ципфа, и мы не имеем ни малейшего представления, почему это так.
Слова используются с разной частотой, что, в принципе, ожидаемо. Например, слово «the» используется гораздо чаще, чем «ecumenical» или «phubbing». Однако анализ частоты употребления слов в больших текстах показывает, что она строго следует определённому статистическому закону.

«Примерно 80 лет назад Джордж Кингсли Ципф (George Kingsley Zipf) заметил, что частота употребления слова, по-видимому, является степенной функцией его ранга, что формулируется как f(r) ∝ rα, где f — это частота слова, r — его ранг по частоте, а α — показатель степени», — объясняется в одной из работ по этой теме.
Проще говоря, самое часто употребляемое слово в языке — например, в английском это «the» — используется в два раза чаще, чем следующее за ним по частоте слово, в три раза чаще, чем третье, в четыре раза чаще, чем четвёртое, и так далее, подчиняясь этой закономерности на удивление долго.
Может показаться, что это причуда исключительно английского языка, но это не так. Закон Ципфа работает практически для всех изученных языков. Будь то английский, хинди, французский, мандаринский или испанский, частота употребления слов уменьшается в соответствии с их ранжированием по популярности.
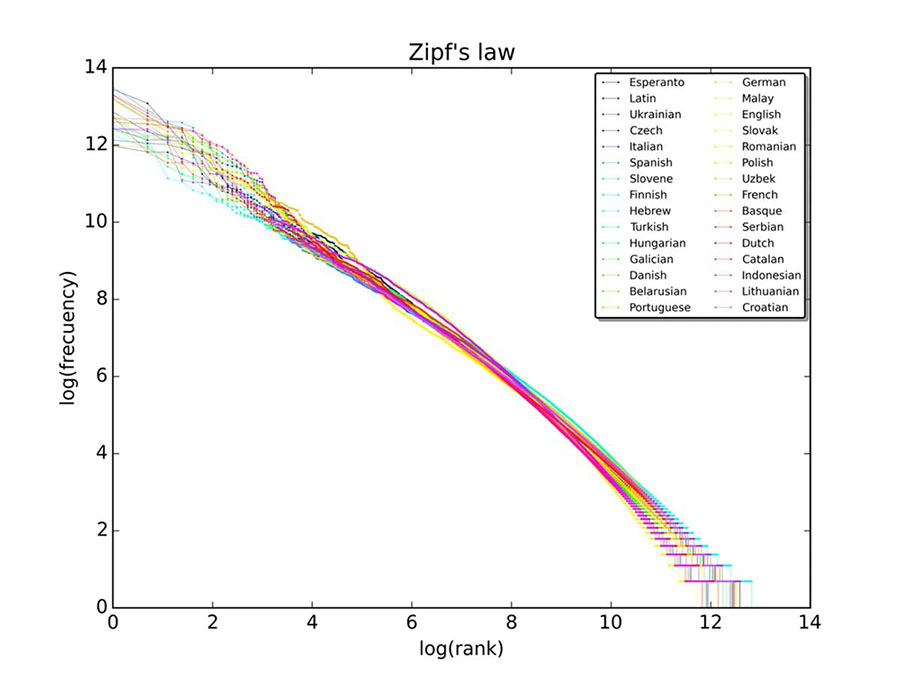
И что ещё более удивительно, этот закон распространяется даже на языки, которые мы до сих пор не расшифровали. Например, слова из таинственной рукописи Войнича также подчиняются этому закону. Даже отдельные крупные тексты показывают эту закономерность, где слово с самым высоким рангом употребляется примерно в два раза чаще, чем следующее, и так далее. Даже Чарльз Дарвин не избежал этой участи: анализ его труда «Происхождение видов» показал, что имеющийся там текст также подчиняется закону Ципфа. На самом деле, подобные закономерности встречаются повсюду.
Довольно странно, не так ли?
«Стоит задуматься о необычности этого закона, — говорится в одном из обзоров. — Сам по себе факт, что частота слов варьируется, уже нетривиален; можно было бы предположить, что все слова употребляются примерно одинаково часто. Но если частота всё же варьируется, непонятно, почему слова подчиняются столь точному математическому правилу — особенно такому, которое никак не связано с их значением.»
Существует множество гипотез, объясняющих это явление: от статистических особенностей до ограничений, связанных с памятью человека и словарным запасом. Сам Джордж Ципф предположил, что этот закон основан на балансе минимизации усилий: говорящие (или писатели) пытаются свести к минимуму свои собственные усилия, используя более часто встречающиеся слова, а слушатели (или читатели) ищут ясности в языке благодаря менее часто используемым словам. Ещё одно развитие этой идеи предполагает, что люди пытаются максимально эффективно передавать информацию, используя слова, которые несут наибольшее количество смысла.
Другая гипотеза заключается в том, что более часто употребляемые слова с течением времени становятся всё популярнее, поскольку язык распространяется и развивается, создавая своего рода эффект снежного кома. Но ни одна из гипотез пока не принята как окончательная, и причина этого явления остаётся загадкой.
Если вы хотите испытать лингвистический экзистенциальный кризис, попробуйте вставить свой собственный (достаточно длинный) текст, роман или научную работу в калькулятор распределения и проверить, подчиняется ли он закону Ципфа. Вас может удивить, насколько предсказуемо ваше использование языка. Но не волнуйтесь — даже «Гамлет» Шекспира ему подчиняется.