


Ризикований та надзвичайно показовий науковий експеримент перевірив ШІ за кермом автомобіля: мультимодальні моделі тест на реальному випробувальному полігоні пройшли з тривожними для розробників результатами. Команда інженерів-робототехніків підключила провідні зорово-мовні моделі (Vision-Language Models, VLM) — зокрема флагманські GPT-4o, Grok та відкриті нейромережі — безпосередньо до механічних приводів серійного електромобіля, транслюючи живе відео з камер у штучний інтелект. Заїзди наочно продемонстрували: попри знання правил дорожнього руху, часова затримка та просторові галюцинації роблять генеративні моделі смертельно небезпечними водіями.
Методика експерименту: як чат-бот отримав прямий доступ до керма
У серійних автономних автомобілях (наприклад, Waymo чи Tesla) застосовується класичний розділений стек сенсорів: нейромережі розпізнають перешкоди, алгоритми просторової орієнтації будують карту середовища, а детерміновані контролери обчислюють точний кут повороту коліс. Проте творці універсального ШІ тривалий час прагнули створити наскрізну модель «від сенсора до дії», де один мультимодальний алгоритм самостійно оцінює дорожню ситуацію та натискає педалі.
Під час експерименту електромобіль обладнали сервоприводами, підключеними до кермової рейки, гальм та акселератора. Стереокамери фіксували дорожнє полотно з частотою високої чіткості та транслювали кадри на хмарний сервер нейромереж.
Від штучного інтелекту вимагалося в режимі реального часу повертати структурований JSON-файл із точними градусами повороту керма та відсотком натискання гальм. Тестування відбувалося на закритому треку з манекенами пішоходів, раптовими перешкодами та звуженнями проїжджої частини.
Вузьке горло латентності: катастрофічне відставання реакції ШІ
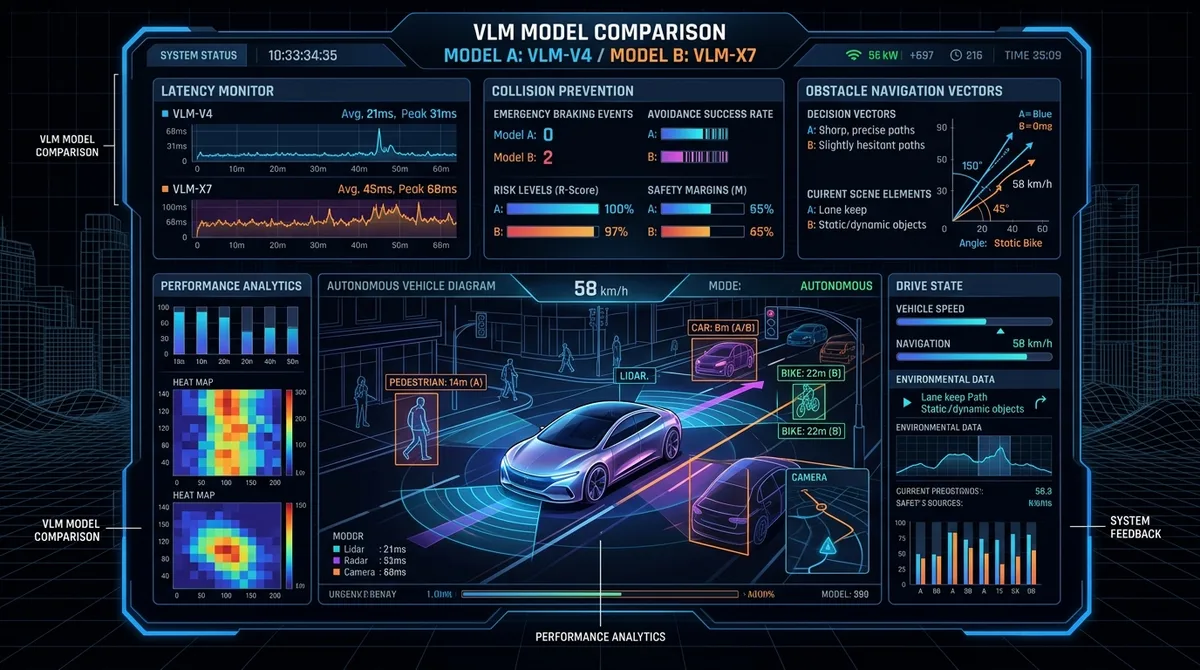
Головною проблемою стала часова затримка передачі та обробки сигналів. Середньостатистичний водій-людина реагує на раптову перешкоду за 200–250 мілісекунд, а спеціалізовані бортові комп’ютери автопілота — за 15–30 мілісекунд. Натомість великим зорово-мовним моделям на інтерпретацію одного кадру та генерацію відповіді знадобилося від 800 до 2500 мілісекунд.
На звичайній швидкості 60 км/год автомобіль проїжджає майже 17 метрів за кожну секунду. За той час, поки модель аналізувала картинку, формулювала внутрішні логічні ланцюжки роздумів та відправляла відповідь через мережу, автомобіль неминуче врізався в манекени перешкод.
Навіть перенесення компактних оптимізованих версій моделей на бортові обчислювальні процесори не вирішило проблему: пікові сплески навантаження призводили до короткочасних «зависань», під час яких некероване авто вилітало за межі траси.
Швидкість ухвалення рішень VLM-моделями у десятки разів повільніша за реакцію людини та автопілотів.
ШІ плутає тіні та зображення на банерах зі справжніми перешкодами, викликаючи екстрені зупинки.
Двовимірний аналіз кадрів призводить до грубих помилок в оцінці дистанції до наближених об’єктів.
Дослідники рекомендують застосовувати мовні моделі лише для стратегії маршруту, а не для прямого руління.
Просторова дезорієнтація та фантомні об’єкти на дорозі
Другим критичним недоліком стала нездатність моделей коректно інтерпретувати тривимірну глибину простору. Навчені на плоских двовимірних фотографіях з інтернету, VLM-моделі постійно плутали масштаб предметів і реальну відстань до них.
Під час руху авто під керуванням ШІ неодноразово різко бив по гальмах перед темними плямами від тіней дерев або рекламними білбордами із зображеннями людей, сприймаючи малюнки за реальних пішоходів. Водночас перед низькими бетонними блоками або бордюрами алгоритм упевнено набирав швидкість.
Особливо небезпечним виявився ефект розпорошення уваги: за наявності яскравих рекламних банерів уздовж дороги нейромережа починала аналізувати текст оголошень, повністю втрачаючи з поля зору дорожню розмітку та покажчики пріоритету.
«Великі мовні моделі здатні бездоганно скласти письмовий іспит із правил дорожнього руху, але повна відсутність фізичного відчуття простору перетворює їх на смертельну загрозу на швидкості понад двадцять кілометрів на годину. На реальній трасі вирішальними є мілісекунди, тоді як універсальна нейромережа витрачає секунди на аналіз кожного кадру.»
Метью Маккарті (Matthew McCarthy), провідний інженер лабораторії автономних систем, координатор випробувань VLM
Порівняльний аналіз: результати заїздів GPT-4o та моделі Grok
Експеримент зафіксував помітну різницю в поведінці різних архітектур. Модель GPT-4o виявила високу точність у розпізнаванні складних дорожніх знаків та сигналів регулювальника, проте демонструвала надмірну нерішучість, що призводило до раптових зупинок посеред перехресть.
Модель Grok діяла значно динамічніше та з дещо меншою затримкою генерації команд, проте набагато частіше допускала критичні зрізання траєкторії на поворотах та виїзди на зустрічну смугу руху.
Науковці одностайно дійшли висновку, що універсальні мультимодальні моделі не можуть використовуватися для безпосереднього кермування. Їхня роль має обмежуватися стратегічним плануванням маршруту, тоді як миттєвий контроль безпеки повинен залишатися за локальними алгоритмами автономних сенсорних систем.
- Експеримент проводився на закритому треку за участю моделей GPT-4o та Grok через хмарний API-шлюз.
- ШІ напряму генерував кут повороту керма та зусилля на педалях на основі аналізу відеопотоку.
- Основними бар’єрами стали висока латентність обчислень та схильність до галюцинацій уваги.
- Регулятори розглядають заборону інтеграції неспеціалізованих VLM у контури активної безпеки автомобілів.
Майбутнє автономного транспорту: безпека понад усе
Натурні випробування чітко окреслили межі можливостей сучасного генеративного інтелекту. Без подолання затримок інференсу та створення математично верифікованих моделей фізичного світу допуск таких алгоритмів до реального дорожнього руху є неприпустимим.
Міжнародні транспортні агенції готують регламенти, які заборонятимуть використання несертифікованих чат-ботів у критичних вузлах керування транспортними засобами. Повний науковий звіт про експеримент доступний на сторінках видання IFLScience.
Ці випробування стали переконливим нагадуванням: справжній інтелект водія полягає не в красномовстві, а в миттєвій реакції та безпомилковому відчутті реальності.