


Необычный и рискованный научный эксперимент проверил ИИ за рулем автомобиля: мультимодальные модели тест на реальном полигоне прошли с серьезными замечаниями исследователей. Команда робототехников подключила передовые зрительно-языковые модели (Vision-Language Models, VLM) — включая флагманские версии GPT-4o, Grok и открытые архитектуры — напрямую к органам управления серийного автомобиля, передавая видеопоток с фронтальных камер прямо в нейросеть. Результаты практических заездов доказали: хотя ИИ способен распознавать дорожные знаки и разметку, сенсорная задержка и пространственные галлюцинации делают современные LLM смертельно опасными водителями.
Методология эксперимента: как чат-бот подключили к рулевой рейке
В классических беспилотных автомобилях (таких как Waymo или Tesla FSD) используются специализированные узкопрофильные нейросети: сверточные фильтры детектируют препятствия, алгоритмы SLAM строят трехмерную карту пространства, а детерминированные планировщики рассчитывают траекторию колес. Однако создатели универсального ИИ давно мечтали об интерфейсе «от пикселя к действию» (End-to-End VLM), где одна гигантская нейросеть смотрит на дорогу и сразу жмет на педали.
В ходе экспериментов исследователи оснастили модифицированный электромобиль роботизированными приводами руля, газа и тормоза. Видеокамеры высокого разрешения непрерывно захватывали дорожную обстановку и отправляли кадры через высокоскоростной API-шлюз на серверы мультимодальных моделей.
Промпт для ИИ формулировался предельно строго: на основе поступающего кадра модель должна была мгновенно сгенерировать JSON-пакет с точными параметрами — углом поворота руля в градусах и процентом нажатия акселератора или тормоза. Испытания проводились на закрытом испытательном полигоне с макетами пешеходов, конусами и неожиданными препятствиями.
Узкое горлышко задержки: почему скорость инференса решает всё
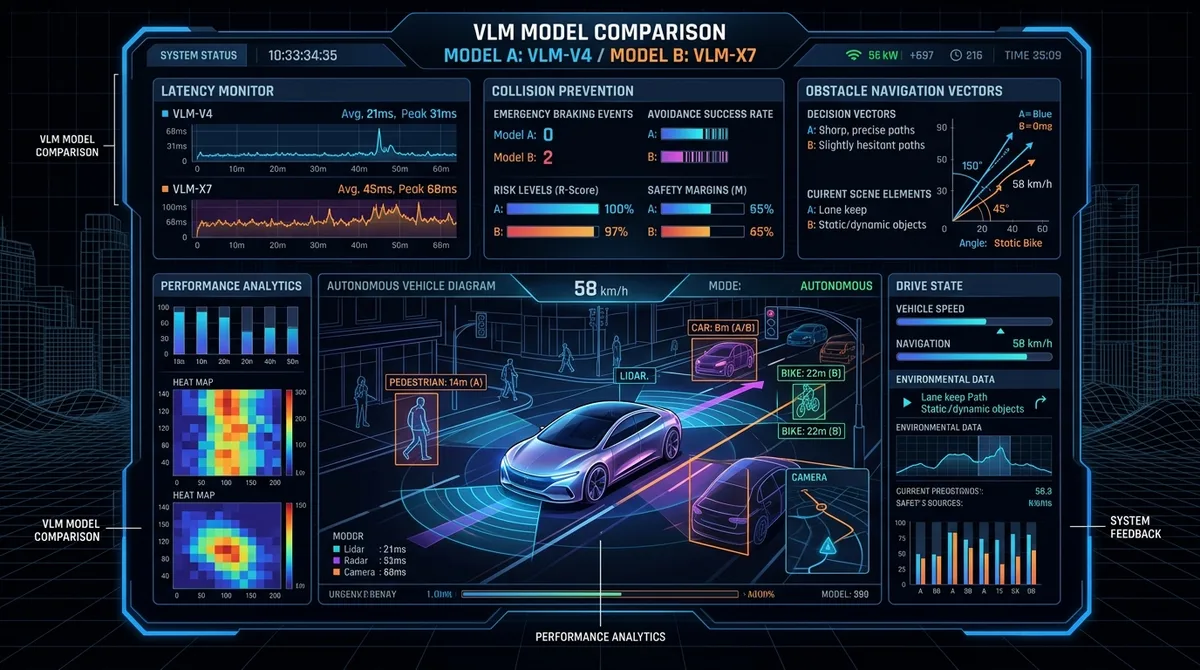
Первой непреодолимой преградой стала временная задержка обработки данных (латентность). В то время как человеческому мозгу требуется около 200–250 миллисекунд для нажатия на тормоз при возникновении внезапной опасности, а специализированные чипы автопилота реагируют за 15–30 миллисекунд, мультимодальные модели тратили на анализ кадра от 800 до 2500 миллисекунд.
На скорости 60 км/ч автомобиль за одну секунду преодолевает почти 17 метров. За время, пока зрительно-языковая сеть анализировала пиксели, генерировала текстовые рассуждения («Я вижу пешехода слева от разметки, следовательно, необходимо применить торможение…») и отправляла ответ, машина проезжала дистанцию, делающую аварию неизбежной.
Даже при использовании оптимизированных квантованных локальных версий моделей время отклика оставалось критически нестабильным. Любой всплеск вычислительной нагрузки на GPU приводил к мгновенной потере управления на крутых поворотах полигона.
Время отклика мультимодальных VLM в 10–50 раз медленнее реакции специализированных автопилотов и человека.
Модели путают тени и плоские рекламные щиты с живыми пешеходами, провоцируя резкие остановки.
Отсутствие истинной 3D-модели мира приводит к фатальным ошибкам оценки расстояния на скорости.
Ученые рекомендуют использовать VLM лишь для стратегического планирования, но не прямого руления.
Пространственная слепота: парадокс двумерных иллюзий
Второй фундаментальный дефект моделей связан с отсутствием истинного трехмерного пространственного мышления. Будучи обученными на миллионах двумерных изображений из интернета, зрительно-языковые модели часто путают относительные размеры объектов и реальную дистанцию до них.
В ходе тестов автомобиль под управлением VLM неоднократно экстренно тормозил перед нарисованными тенями от мостов или рекламными баннерами с изображением людей, принимая плоские изображения за реальные препятствия. Напротив, в ситуациях с полупрозрачными преградами, низкими бордюрами или лежачими полицейскими модель уверенно жала на газ, не идентифицируя угрозу целостности подвески.
Особенно ярко проявилась проблема «галлюцинаций внимания»: когда перед автомобилем одновременно появлялись дорожный знак ограничения скорости и яркая витрина магазина, модель фокусировалась на чтении текста на вывеске, полностью игнорируя стоп-линию перекрестка.
«Большие языковые модели обладают энциклопедическими знаниями о правилах дорожного движения, но полное отсутствие воплощенного физического интеллекта превращает их в фатальную угрозу на скорости выше 20 километров в час. На дороге счет идет на миллисекунды, а инференс мультимодальной сети требует секунды на осмысление каждого кадра.»
Мэтью Маккарти (Matthew McCarthy), ведущий инженер лаборатории автономной робототехники, координатор натурных испытаний VLM
Сравнение моделей: GPT-4o, Grok и специализированные энкодеры
Тестирование выявило существенные различия между моделями разных разработчиков. Флагманская модель GPT-4o показала наивысшую точность в распознавании сложных дорожных сценариев (например, регулировщиков движения с жезлами), но страдала от чрезмерной осторожности, регулярно впадая в ступор на перекрестках с круговым движением.
Модель Grok продемонстрировала более агрессивный стиль вождения с минимальными задержками генерации команд, однако значительно чаще допускала опасные срезания траектории на поворотах и ошибки позиционирования в пределах полосы.
Исследователи подчеркивают, что будущее беспилотного транспорта лежит не в замене автопилотов чат-ботами, а в создании гибридных архитектур, где языковые модели служат лишь высокоуровневыми стратегами, а прямое управление доверяется локальным контурам автономных сенсорных систем.
- Испытания проводились на закрытом полигоне с передачей видео в модели GPT-4o и Grok через API.
- Модели преобразовывали изображение дороги в команды угла поворота руля и давления на педали.
- Главной угрозой безопасности стала высокая латентность инференса и потеря фокуса внимания.
- Регуляторы готовят запрет на применение неспециализированных генеративных нейросетей в автопилотах.
Будущее автономности: уроки натурных дорожных испытаний
Эксперимент наглядно показал границы применимости универсального искусственного интеллекта. До тех пор пока архитектура трансформеров не научится гарантированному рассуждению в реальном времени с нулевой задержкой и физической верификацией законов динамики Ньютона, доверять им руль общественного транспорта категорически недопустимо.
Научное сообщество призывает регуляторов ввести жесткие стандарты лицензирования алгоритмов управления беспилотниками, исключающие использование несертифицированных генеративных сетей в критических узлах безопасности. С полными материалами исследования можно ознакомиться на научно-популярном ресурсе IFLScience.
Уроки этих заездов напоминают нам: настоящий интеллект требует не только красноречия, но и глубокого физического чувства реальности.